我在日本读书,平时用网页看 B 站。家里的带宽明明远不止这点,可 1080P 1 倍速只是凑合,一开 4K、切 2 倍速,或者往后拖一下进度条,画面就开始转圈。让claude查了一下,原来是 CDN 对每个请求单独限速,而对每个视频播放器一次只发一个请求,所以画质一高视频就卡。
B 站,你在搞什么?降本也不是这样降的啊,对得起我的大会员吗?
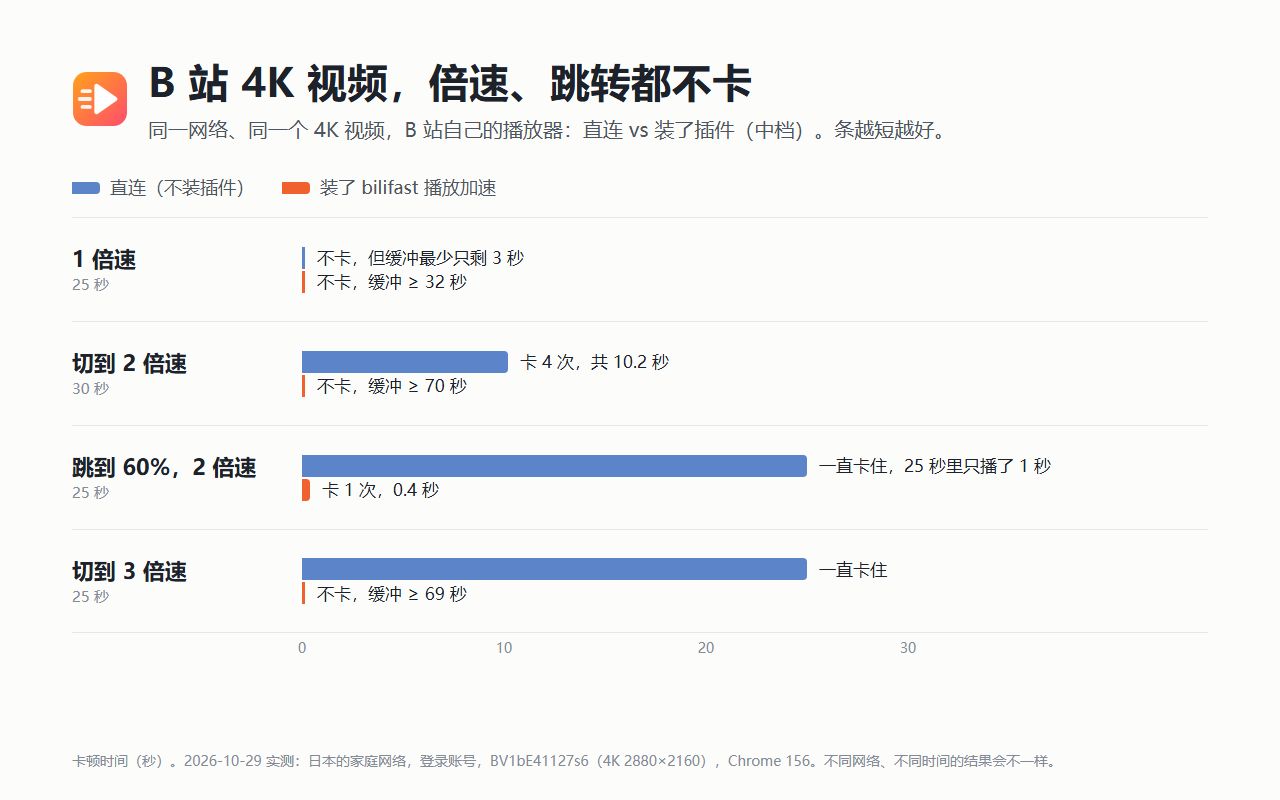
于是我写了个 Chrome 插件 bilifast,把一个请求拆成十几个。同一个网络、同一个视频、B 站自己的播放器锁定 4K,装插件前后是这样的:
| 不装插件 | 装了插件 | |
|---|---|---|
| 1 倍速 25 秒 | 不卡,但缓冲最少只剩 3 秒 | 不卡,缓冲 ≥ 32 秒 |
| 切到 2 倍速 30 秒 | 卡 4 次,共 10.2 秒 | 不卡,缓冲 ≥ 70 秒 |
| 跳到 60% 后 2 倍速 25 秒 | 一直卡住,只播了 1 秒 | 卡 1 次,0.4 秒 |
| 切到 3 倍速 25 秒 | 一直卡住 | 不卡,缓冲 ≥ 69 秒 |
不锁画质的时候差别更直观:不装插件,播放器的自适应码率一直停在 480x360;装了以后,它自己就切到了 4K。
插件只申请了 storage 一个权限,不读 cookie,不收集任何数据,画面、弹幕、评论、播放记录都还是 B 站自己的。这篇文章讲它为什么有效,以及我是怎么一步步做出来的。中间我自己也搞错过一次:第一版需要在电脑上跑一个本地程序,后来一次测量让我发现根本不需要。
一、先从下载说起
多年以后,面对行刑队,奥雷里亚诺·布恩迪亚上校将会回想起父亲带他去见识冰块的那个遥远的下午。
——加西亚·马尔克斯《百年孤独》
这件事的起点不是播放,而是下载。我之前写过一个 B 站下载器 bilidl,最早下载速度只有 2 MB/s 左右,而我家的带宽远不止这些。
测了一圈发现两个问题:
- B 站给的默认节点很慢。 接口返回的视频地址是
upos-sz-mirrorcosov.bilivideo.com,备用地址是upos-hz-mirrorakam.akamaized.net。名字里带ov的是海外节点,akamai 是海外 CDN。在我这里,它们 4 个线程加起来只有 0.35~0.46 MB/s。 - 每条连接都被单独限速,大约 1~1.5 MB/s。线程开得越多,总速度几乎线性增长。
视频地址里的签名参数在 query 里,和域名无关,所以可以把域名换成别的 B 站节点,签名照样有效。把域名换成更快的节点,再把线程从 6 个加到 16 个,同一个 1080P 视频的稳定速度从 2.35 MB/s 变成 24 MB/s。
当时我得出的结论是「CDN 按连接限速」。记住这个结论,后面它被推翻了。
二、网页播放为什么卡
什么也没有发生,没有人来,没有人去,真可怕。
——贝克特《等待戈多》
用无头 Chrome 加 CDP 记录 B 站播放器的网络请求,可以看到:
- 播放器用 DASH,视频和音频是分开的
.m4s文件,每次用一个Range: bytes=a-b请求取一个分段; - 一次只发一个请求,而且所有请求都走同一条 HTTP/2 连接;
- 用的就是接口默认给的那个慢节点。我测的时候,cosov 单个请求只有 0.68 MB/s,偶尔还会几秒没响应;
- 播放器自己最多缓冲到领先播放位置约 72 秒。2 倍速时也是 72 秒,换算成实际时间只剩 36 秒。
我测试用的 4K 视频平均码率约 1.97 MB/s,2 倍速就需要约 4 MB/s。一个每秒只能拿到零点几到一两 MB 的请求,怎么也跟不上。
问题和下载时一样:单个请求太慢,又只有一个请求。下载器的办法是拆成多个请求并发拉,那播放能不能也这样做?
三、第一版:在本机跑一个代理
你建好了,他就会来。(If you build it, he will come.)
——电影《梦幻之地》(1989)
当时我还以为是按连接限速,而浏览器对同一个域名只开一条 HTTP/2 连接。在页面里怎么并发都只有这一条连接,没用。所以第一版的思路是:把播放器的请求转给本机的程序,让它用多条 TCP 连接去拉。
具体做法:
- Chrome 插件用
declarativeNetRequest把播放器对.m4s的请求重定向到http://127.0.0.1:8765/play/<原始链接>; - 本机的 Python 程序把每个请求拆成 1 MB 的块,用 16 个线程从实测最快的几个节点并发拉取,再按顺序流式返回给播放器;
- 同时按播放器的取数速度预读约 90 秒。2 倍速时取数速度翻倍,预读量也跟着翻倍。
效果不错:模拟播放器在 1x → 2x → 跳到 60% → 3x 四个阶段都不卡了。但也踩了不少坑:
- Chrome 的「本地网络访问」授权。 从 bilibili.com 的页面请求
127.0.0.1要用户授权,没授权时视频完全放不出来,停在 0 秒。所以插件要先 ping 一下本地程序,通了才开重定向。 - 本地程序挂掉时要立刻退回直连。 只靠定时 ping 太慢:播放器几秒内重试几次都失败,就会报错并把进度重置到 0。最后改成用
webRequest盯着这些请求,一出错就撤掉重定向规则。 - 第一版的调度有问题。 一个请求覆盖的几个块是串行排队的;单个慢连接一直慢慢给数据、不触发超时,就会把整个请求拖住,p95 请求耗时达到 2
17 秒。改成一个请求的块一起并发拉取,再加上「2.5 秒还没拉完就换个节点再拉一份」(对冲)以后,p95 降到 1.13.3 秒。
能用,但门槛太高:要装 Python 程序,要开着一个黑窗口,还要点授权。我一直觉得这不是一个能推荐给别人用的东西。
四、一次测量:到底按什么限速?
在没有掌握事实之前就进行推理,是个绝大的错误。
——柯南·道尔《波希米亚丑闻》
转折出现在我想搞清楚一个问题的时候:限速的单位真的是 TCP 连接吗?
如果是按连接限速,那浏览器里确实没办法。但如果是按单个请求限速,那 HTTP/2 本来就支持在一条连接上同时跑很多个请求(stream),浏览器里并发 fetch 就够了,根本不需要本地程序。
打个比方:CDN 像一台按「每根吸管」限流的饮料机,播放器只插了一根吸管。HTTP/2 连接是一个杯子,一个杯子里可以插很多根吸管。第一版以为限的是杯子,所以在本机搬来一台机器开很多个杯子;如果限的其实是吸管,那在一个杯子里多插几根就行了。
我用 Node 写了个测速脚本,对比几种情况:1 条 h2 连接上开 1 / 4 / 16 个请求,4 / 16 条独立的 HTTP/1.1 连接,4 条 h2 连接各开 4 个请求。每个请求取 1 MB,每组跑 8 秒。
第一次测出来的结果让我差点放弃:单条 h2 连接只有 0.3~0.6 MB/s,加多少个请求都不涨,看起来就是按连接限速。
后来发现是测试工具的问题:Node 的 http2 模块默认流控窗口只有 64 KB,延迟稍高一点,速度就被窗口卡死了,和 CDN 无关。按 Chrome 的设置把窗口放大(单个 stream 6 MB,整条连接 15 MB)以后,结果完全不一样(单位 MB/s):
| 节点 | 1 连接 × 1 | 1 连接 × 4 | 1 连接 × 16 | 4 条 HTTP/1.1 | 16 条 HTTP/1.1 |
|---|---|---|---|---|---|
| mirror08ct | 4.25 | 17.6 | 20.1 | 19.0 | 53.4 |
| mirrorhwb | 3.13 | 17.5 | 40.3 | 19.6 | 52.5 |
| mirrorhw | 5.16 | 19.9 | 31.2 | 19.8 | 48.7 |
1 条连接上开 4 个请求,和 4 条独立连接一样快。 限速的单位是请求,不是连接。16 个请求时单条连接比 16 条连接慢一些,那是单条 TCP 本身的限制(拥塞窗口、丢包),对播放来说已经绰绰有余。
再到真实的 Chrome 里验证:打开 B 站视频页,在页面里对同一个节点并发 fetch,用 CDP 看每个响应的 connectionId。全程只有 1 条 h2 连接,并发 1 / 4 / 16 分别是 3.85.2 / 16.520.5 / 32~44 MB/s。
还有一个好消息:B 站的视频 CDN 本来就允许 bilibili.com 页面跨域请求(CORS),所以插件在页面里发请求,连 CDN 域名的 host 权限都不需要。
这几个测量是同一天做的。也是在这一天,我决定把本地程序整个去掉。
11 月我又测了一次:同一条连接上并发 1 / 4 / 16 是 4.5 / 18.8 / 26.2 MB/s,结论没变。不过 CDN 的速度天天在变,上面的绝对值只能参考,比例关系才是结论。
五、第二版:只装一个插件
完美不是无可增添,而是无可删减。
——圣埃克苏佩里《人的大地》
剩下的问题是:怎么让播放器的请求走插件?
接管播放器的 XHR
B 站播放器在主线程用 XMLHttpRequest 取分段:responseType = "arraybuffer",带 Range: bytes=a-b 请求头。(有意思的是,我两天前测的时候它还是在 Web Worker 里发请求的,说明播放器随时会改。所以插件的原则是:认不出的请求一律原样放行。)
Chrome 插件的内容脚本可以设置 "world": "MAIN" 和 "run_at": "document_start",在页面自己的脚本之前运行,和页面共用同一个 window。我在这里把 window.XMLHttpRequest 换成一个子类:
class XMLHttpRequest extends NativeXHR {
  send(body) {
    // 只接管:GET、异步、arraybuffer、Range 两端都有、upos 节点上的 .m4s、开关开着
    if (!canTakeOver(this)) return super.send(body);

    engine.request(url, a, b, signal).then(({ data, start, end, size }) => {
      // 在实例上伪造响应,按原生 XHR 的顺序派发事件
      fake(this, { readyState: 2, status: 206 }); fire(this, "readystatechange");
      fake(this, { readyState: 3 });              fire(this, "readystatechange");
      fire(this, "progress", data.byteLength);
      fake(this, { readyState: 4, response: data }); fire(this, "readystatechange");
      fire(this, "load"); fire(this, "loadend");
    }, () => super.send(body));  // 出任何错都退回原请求
  }
}
fake() 用 Object.defineProperty 在实例上覆盖 readyState、status、response、getResponseHeader 这些只读属性,响应头里带上正确的 Content-Range。为了让播放器察觉不到区别,还要模拟几个原生行为:
- 播放器调用
abort()时,取消插件自己的请求,派发abort事件; - 设了
xhr.timeout的,到点派发timeout(播放器靠它换节点重试); - 重新
open()时悄悄丢掉进行中的请求,和原生一样不派发事件。
最重要的是最后一行:插件这边出任何错,都调用原来的 send,等于退回直连。插件坏了,视频最多变回原来那样,不会放不出来。
权限
整个插件只申请 storage 一个权限(记住开关和档位),没有 host 权限,没有远程代码。内容脚本只在 B 站的视频页、列表页和番剧页上运行。
六、调度:把一个请求拆成十几个
凡治众如治寡,分数是也。
——《孙子兵法·势篇》
接管请求只是入口,真正决定效果的是调度。这部分是从第一版的 Python 代码移植过来的,又改了几处。
1 MB 分块。 播放器的每个请求被拆成 1 MB 的块。缓存以 URL 路径为键,和节点、签名无关,同一块正在下载时不会重复拉。
两级优先级。 播放器正在等的块是「紧急」,其余是「预读」。普通并发先拿紧急块再拿预读,另外还有一个只拉紧急块的小并发池,预读把普通并发占满时,紧急块也不用排队。
对冲。 紧急块 2.5 秒还没拉完,就同时向另一个节点再拉一份,谁先到用谁,并取消另一路。这是专门对付「慢但不断」的连接:它一直有数据,不会触发超时,但能把一个请求拖十几秒。另外,一块拉了 10 秒还没拉完也算失败。
倍速自适应预读。 预读窗口 = 最近 20 秒播放器的取数速度 × 90 秒(有上下限)。取数速度已经包含了码率和倍速,所以切到 2 倍速时窗口自动翻倍,不需要知道播放器开了几倍速。
挑节点。 这是改动最大的一处。各节点的速度不是固定的,同一个节点隔几分钟能差几倍,节点还会直接下线(我 10 月中旬测的最快节点,两周后已经解析不到了)。所以插件对每个节点记录单个请求速度的滑动平均,运行时动态排序。
第一版照搬 Python 的规则:预读块在最快的 3 个节点之间平均分。结果有一天各节点的速度差了上百倍:aliov 单个请求约 20 MB/s,另外几个只有 0.10.4 MB/s,而且是一直慢慢给数据。按块数平均分时,并发几乎全耗在慢节点上(快节点一秒拉完一块,慢节点一块要拉十几秒),总速度只有 28 MB/s,2 倍速、3 倍速都卡。
后来改成:
- 预读只在「速度不低于最快节点 30%」的节点之间分,按速度加权,而不是按块数平均;
- 没测过的和慢的节点只拿 10% 的机会试探,同一时间最多 1 个,让排名能跟上变化;
- 紧急块直接用测过的最快节点;
- akamai 不参与排序:它单个请求不慢,但总带宽封顶约 1 MB/s,加并发也不涨,按单个请求的速度排会被误判成快节点。所以它只在第 3 次重试时用。
改完以后,同样的场景四个阶段都不卡了。
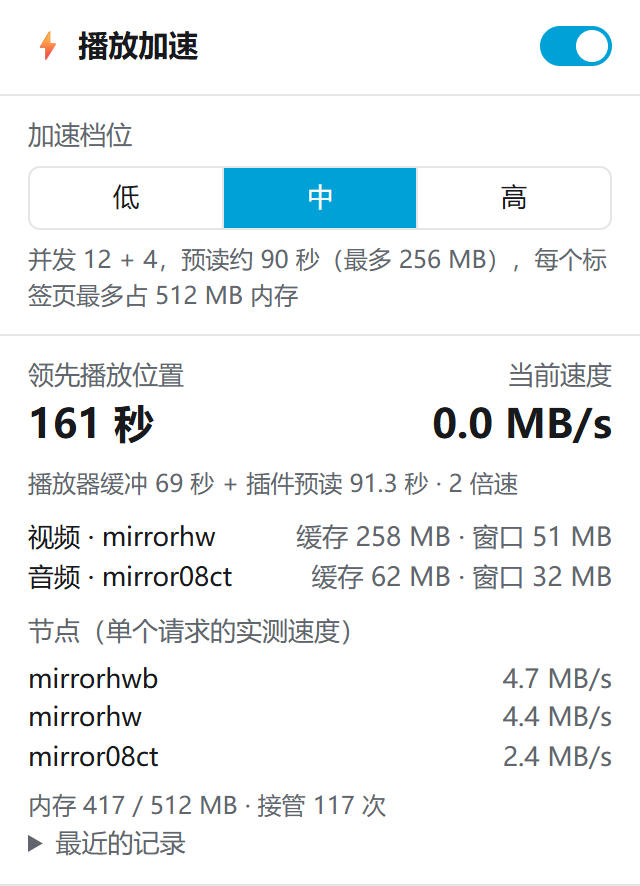
内存。 每个标签页有内存上限,超了就不再开始新的预读,先丢播放位置之前的块。闲置 10 分钟释放,关掉加速时立刻全部释放。弹出页里有低 / 中 / 高三档:
| 档位 | 并发 | 预读 | 内存上限 |
|---|---|---|---|
| 低 | 6 + 3 | 60 秒 | 256 MB |
| 中(默认) | 12 + 4 | 90 秒 | 512 MB |
| 高 | 24 + 6 | 120 秒 | 1 GB |
单个节点上 16 个并发就有几十 MB/s,4K 3 倍速约需 6 MB/s,所以低档也够用。档位主要决定预读多远、占多少内存。
七、怎么确认它是对的
纸上得来终觉浅,绝知此事要躬行。
——陆游《冬夜读书示子聿》
改播放器的网络请求,最怕的是数据错了:画面花屏,或者偶尔卡死又查不出原因。所以测试我做了好几层:
- 离线测调度:用假的 CDN 测各种 Range(跨块、不对齐、文件末尾、超出末尾)、8 个请求落在同一块只拉一次、慢节点触发对冲、全部节点出错时退回直连、内存上限等。
- 逐字节比对:在真实页面里用 XHR 发同样的 Range,插件返回的数据和直连的 SHA-256 完全一致。用 CDP 让插件的请求全部失败时,确认请求退回了直连、数据照样正确。
- 真实播放器:无头 Chrome 加载插件,打开真实视频页,锁定 4K,按 1x → 2x → 跳到 60% → 3x 统计卡顿。开头那张表就是这么来的。整个过程中播放器自己发出的分段请求是 0 个,全部由插件返回,没有一次退回直连。
- 页面跳转:切换分 P、切换清晰度、列表页的下一个视频、番剧换集,B 站都不刷新页面。确认切换后新的流照样被接管,旧的流也不会继续占着并发预读。
八、限制
人得知道自己的局限。(A man’s got to know his limitations.)
——电影《紧急搜捕令》(1973)
- 只加速 www.bilibili.com 上的播放。嵌入在其他网站里的播放器和直播不加速。
- 不能绕过大会员和付费限制,看不了的视频装了也看不了。
- 后台标签页里的定时器会被浏览器限流,对冲和超时会变迟钝。
- 每个标签页各自一份缓存,开很多个视频页时内存会叠加。
- 网络本来就很快、离 B 站节点很近的话,提升不明显。
另外要说明:上面的数字都来自我一个人的网络和少数几个视频。我能确定的只有两件事:海外默认分到的节点很慢,CDN 对每个请求单独限速。至于这是有意的策略还是别的原因,我不知道。
安装
愿原力与你同在。(May the Force be with you.)
——电影《星球大战》(1977)
- Chrome 应用商店:bilifast 播放加速
- 介绍页:yangxiaomao.com/bilifast
- 源代码(MIT):github.com/Yangxiamao/bilifast
装好后刷新 B 站视频页,照常看就行。工具栏图标上的数字是缓冲领先播放位置的秒数。
回头看,从「要装本地程序」到「只装一个插件」,中间只隔了一次测量。如果当初没有怀疑「按连接限速」这个结论,或者被 Node 的 64 KB 窗口骗过去,现在大概还在让用户点「允许访问本地网络」。